语音识别与转录
Prepped 怎样把会议中的语音转成文字,有哪几种识别方式,以及怎样修改转录中听错的词。
Prepped 分别收听两个声音通道。系统声音是你电脑播放的声音,也就是会议软件里的对方;麦克风是你自己。只在对方的通道中识别问题。
在 Windows 11 上,系统声音包括除 Prepped 以外所有程序的声音,不管每个程序用的是哪个扬声器或耳机:会议软件设在耳机上、Windows 的默认输出是另一个设备时,也能听到对方。在 Windows 10 上,系统声音是默认输出设备播放的声音。
语音怎样变成文字
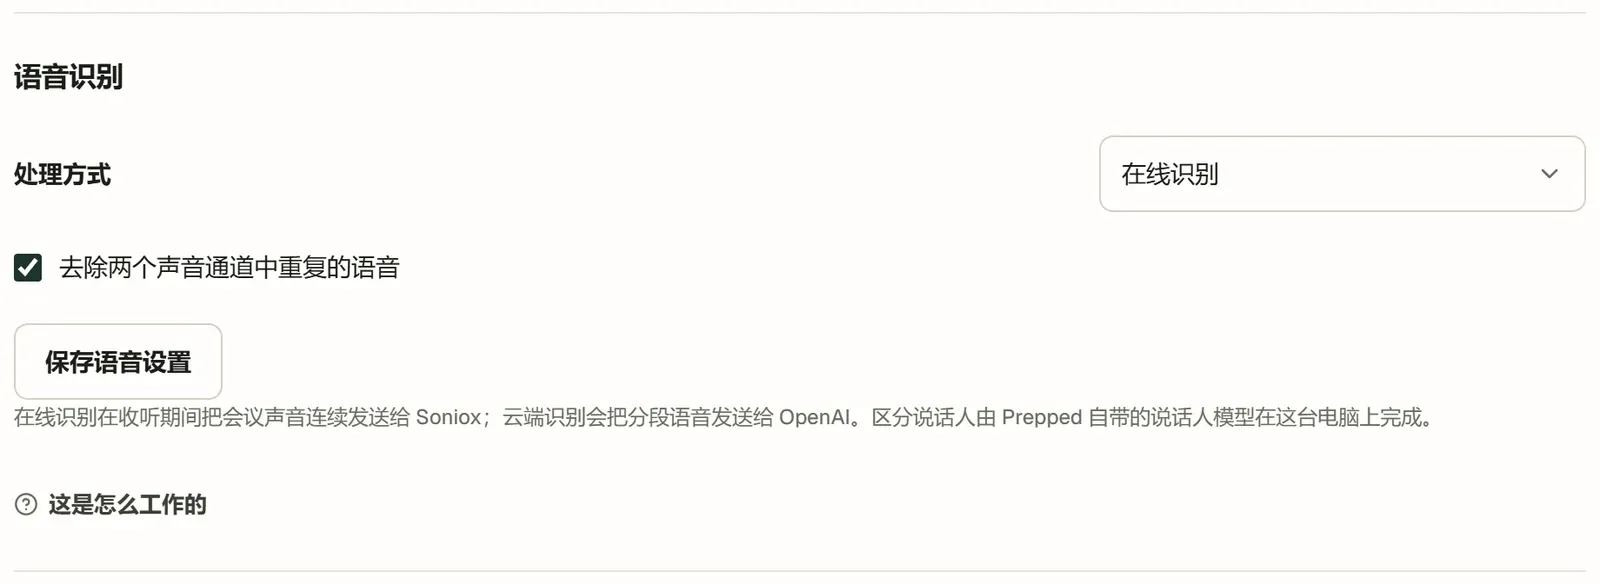
Prepped 在线识别语音。在设置的桌面与音频中的语音识别里选择方式。
| 方式 | 怎样工作 | 费用 |
|---|---|---|
| 在线识别(默认) | 收听期间,会议的声音经过 Prepped 服务连续发送给 Soniox。听到的话随时显示,说话人说完后大约十分之一秒文字就会确定。在 Prepped 用七种语言的会议和朗读录音做的测试中,七组里有六组 Soniox 在比较的四种识别方式中错误最少。 | 每收听一小时 0.12 美元(12 credits);停止收听时连接关闭 |
| 云端转录 | 电脑先找出有人说话的片段,再把每一段经过 Prepped 服务发送给 OpenAI 的转写模型。 | 每分钟语音大约 0.003 美元 |
两种方式都用你的额度支付,计入每日限额;会议设定了自己的限额时,也计入会议的限额。打开实时翻译后,每小时大约再增加 0.50 到 1.20 美元。网页版和手机版同样在线识别。在浏览器中,浏览器询问时请共享带声音的会议标签页或屏幕,这样 Prepped 才能听到对方。
语言
在线识别支持会议的会议语言列表中的所有语言,大约 60 种。在每场会议的会议语言中设置会议里说的语言。对于中文、粤语、英语、日语、韩语、西班牙语和法语,Prepped 会提示识别服务按这种语言识别。
人名和术语
Prepped 会把一场会议可能用到、语音识别却想不到的词告诉它,例如参会者的名字和你的资料中反复出现的术语。这样,人名和专业术语会按你资料中的写法识别出来。
使用在线识别时,Soniox 还会把会议资料当作背景一起听,例如职位描述和你的简历,英文最多约 6,000 个字符,中文约 1,500 个字。在 Prepped 的测试中,有了这些资料,会议自己的项目名称识别正确的次数多了很多(一场一小时的会议里,Obscuro 从 9 次变成 24 次)。每次开始收听时,Soniox 会对这些资料收费,每个声道不到 1 个 credit。
说话人
在电脑上,一个说话人模型(NVIDIA Nemotron 3 Diarization,约 107 MB)区分系统声音中的不同声音。转录用编号标记他们,编号在这场会议中保持不变;不确定时标记为未知说话人。在转录中给说话人改名后,他的每一句话都会使用新名字。
有些电脑在开会时跑不动说话人模型。使用在线识别时,Prepped 会一边收听一边测量。如果连续两分钟,模型处理音频所用的时间接近音频本身的长度,或者电脑一直几乎满负荷,又或者对方的话总要等说话人模型处理完才能交给回答,就在这场会议余下的时间里改由 Soniox 区分说话人,不另外收费。下一场会议仍然先用说话人模型。
用扬声器外放而不戴耳机时,麦克风会再次听到对方的声音。去除两个声音通道中重复的语音(默认开启)会去掉麦克风上和对方刚说过的话高度相同的文字。
转录
会议页面显示完整的转录,同一个人连续说的话合成一段,带有时间和说话人,停顿或换人时另起一段。在会议工作区的转录标签中点一句话就能修改它,修改会保留历史,并更新还没有回答的问题。查找转录中的文字可以搜索转录。除非你在桌面应用中打开了会议记录,原始声音不会被保存。
一场有资料的会议结束后,Prepped 会用会议服务商的低价模型(OpenAI 是 GPT-6 Luna)带着资料再读一遍转录,改正语音识别听错的内容,例如人名和术语;其他内容一律不改,你编辑过的句子也保持原样。有改正的段落下方显示已用会议资料改正,展开可以看到原来识别的文字,点恢复原来识别的文字可以撤销那一处改正。用 GPT-6 Luna 时,每小时会议大约花费 1 个 credit。没有资料的会议不做改正,因为在 Prepped 的测试中,没有资料时改正反而让转录变差。