Reconocimiento de voz y transcripción
Cómo pasa Prepped a texto lo que dicen los dos lados de una reunión y distingue quién habla, y cómo corregir nombres y palabras de la transcripción.
Prepped oye dos canales y los mantiene separados. El Audio del sistema es lo que suena en tu ordenador, la otra parte en una app de reuniones, y el Micrófono eres tú. Las preguntas se detectan solo en el canal de la otra parte.
En Windows 11, el audio del sistema es el sonido de todas las apps salvo Prepped, en el altavoz o los auriculares que use cada una, así que una app de reuniones configurada con tus auriculares se oye aunque la salida predeterminada de Windows sea otro dispositivo. En Windows 10 es lo que suena en la salida predeterminada.
Cómo la voz se convierte en texto
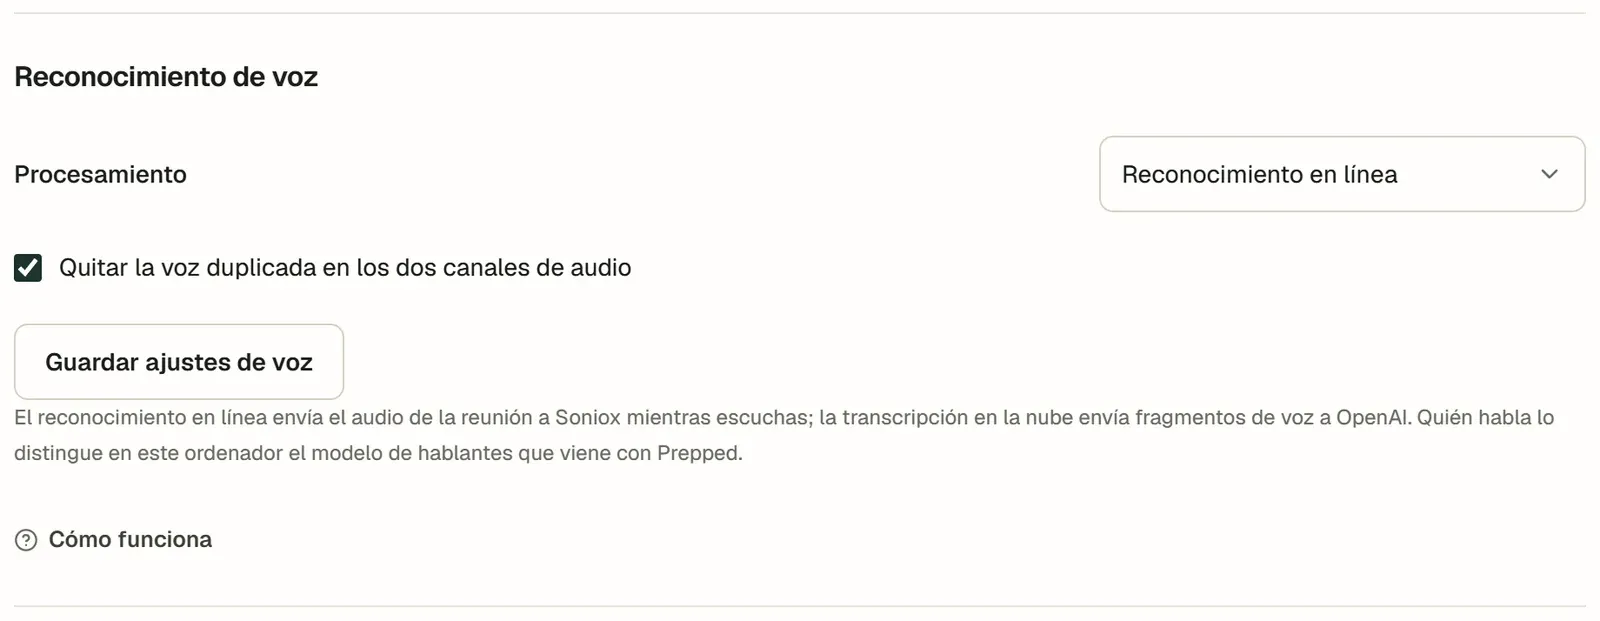
Prepped reconoce la voz en línea. Elige cómo en Configuración, luego Escritorio y audio, luego Reconocimiento de voz.
| Forma | Cómo funciona | Coste |
|---|---|---|
| Reconocimiento en línea (lo predeterminado) | Mientras escuchas, el audio de la reunión se envía sin pausa a Soniox a través del servicio de Prepped. Ves las palabras a medida que se oyen, y se fijan una décima de segundo después de que la persona termina de hablar. En las pruebas de Prepped con reuniones y lecturas en siete idiomas, Soniox cometió menos errores que los otros tres reconocedores comparados en seis de ellos. | 0,12 US$ (12 créditos) por hora de escucha; la conexión se cierra cuando dejas de escuchar |
| Transcripción en la nube | El ordenador encuentra el habla y envía cada fragmento al modelo de transcripción de OpenAI a través del servicio de Prepped. | Unos 0,003 US$ por minuto de habla |
Las dos se pagan con tus créditos, dentro del límite diario y del de la reunión cuando tiene uno. La traducción en directo, si la activas, añade entre unos 0,50 y 1,20 US$ por hora. La aplicación web y la versión para el móvil también reconocen la voz en línea. En un navegador, comparte la pestaña o la pantalla de la reunión con su audio cuando te lo pida, para que Prepped oiga a la otra parte.
Idiomas
El reconocimiento en línea entiende todos los idiomas de la lista Idioma de la reunión, unos 60. Indica lo que se habla en el Idioma de la reunión de cada reunión. Para chino, cantonés, inglés, japonés, coreano, español y francés, Prepped le dice al reconocedor que espere ese idioma.
Nombres y términos
Prepped da al reconocimiento de voz las palabras que probablemente use una reunión y que no esperaría, como los nombres de los participantes y los términos que se repiten en tu material. Así los nombres y la jerga salen escritos como en tu material.
Con el reconocimiento en línea, Soniox también oye el material de la reunión como contexto, como la descripción del puesto y tu currículum, hasta unos 6.000 caracteres en inglés o 1.500 en chino. En las pruebas de Prepped, los nombres de los proyectos de la reunión salieron bien muchas más veces con él (Obscuro 24 veces en lugar de 9 en una reunión de una hora). Soniox cobra el material cada vez que empiezas a escuchar, menos de un crédito por canal.
Quién habla
En el ordenador, un modelo de hablantes (NVIDIA Nemotron 3 Diarization, unos 107 MB) distingue las voces del audio del sistema. La transcripción las marca con números que se mantienen en la reunión, o Hablante desconocido cuando no está seguro. Cambia el nombre de un hablante en la transcripción y se aplica a todas sus frases.
Algunos ordenadores son demasiado lentos para el modelo de hablantes durante una reunión. Con el reconocimiento en línea, Prepped lo mide mientras escucha. Si durante dos minutos seguidos el modelo necesita casi la duración del propio audio para seguirle el ritmo, o el ordenador está casi siempre ocupado, o si las palabras de la otra parte esperan una y otra vez al modelo antes de llegar a la respuesta, Soniox distingue a los hablantes en su lugar durante el resto de esa reunión, sin coste adicional. La reunión siguiente vuelve a empezar con el modelo de hablantes.
Con altavoces en vez de auriculares, el micrófono vuelve a oír a la otra parte. Quitar la voz duplicada en los dos canales de audio (activado por defecto) descarta el texto del micrófono que repite casi igual lo que la otra parte acaba de decir.
La transcripción
La página de la reunión muestra la transcripción completa, en la que lo que una persona dice sin interrupción forma un párrafo con su hora y su hablante, y una pausa u otra persona empiezan el siguiente. Corrige un fragmento haciendo clic en él en la pestaña Transcripción del espacio de trabajo de la reunión. Las correcciones guardan su historial y actualizan las preguntas aún sin responder. Busca texto en esta transcripción la recorre. El audio original no se guarda salvo que actives los registros de reuniones en la app de escritorio.
Cuando termina una reunión con material, Prepped lee su transcripción una vez más con el material, con el modelo económico del proveedor de la reunión (GPT-6 Luna con OpenAI), y corrige lo que el reconocimiento de voz entendió mal, como nombres y términos; no cambia nada más, y los fragmentos que editaste quedan como los escribiste. Un párrafo con correcciones muestra Corregida con el material de la reunión. Ábrelo para ver lo que se reconoció, y elige Restaurar lo reconocido para deshacer un cambio. Con GPT-6 Luna cuesta alrededor de un crédito por hora de reunión. Una reunión sin material no se corrige, porque en las pruebas de Prepped la corrección sin material empeoró la transcripción.